J’ai optimisé cet article avec l’IA.

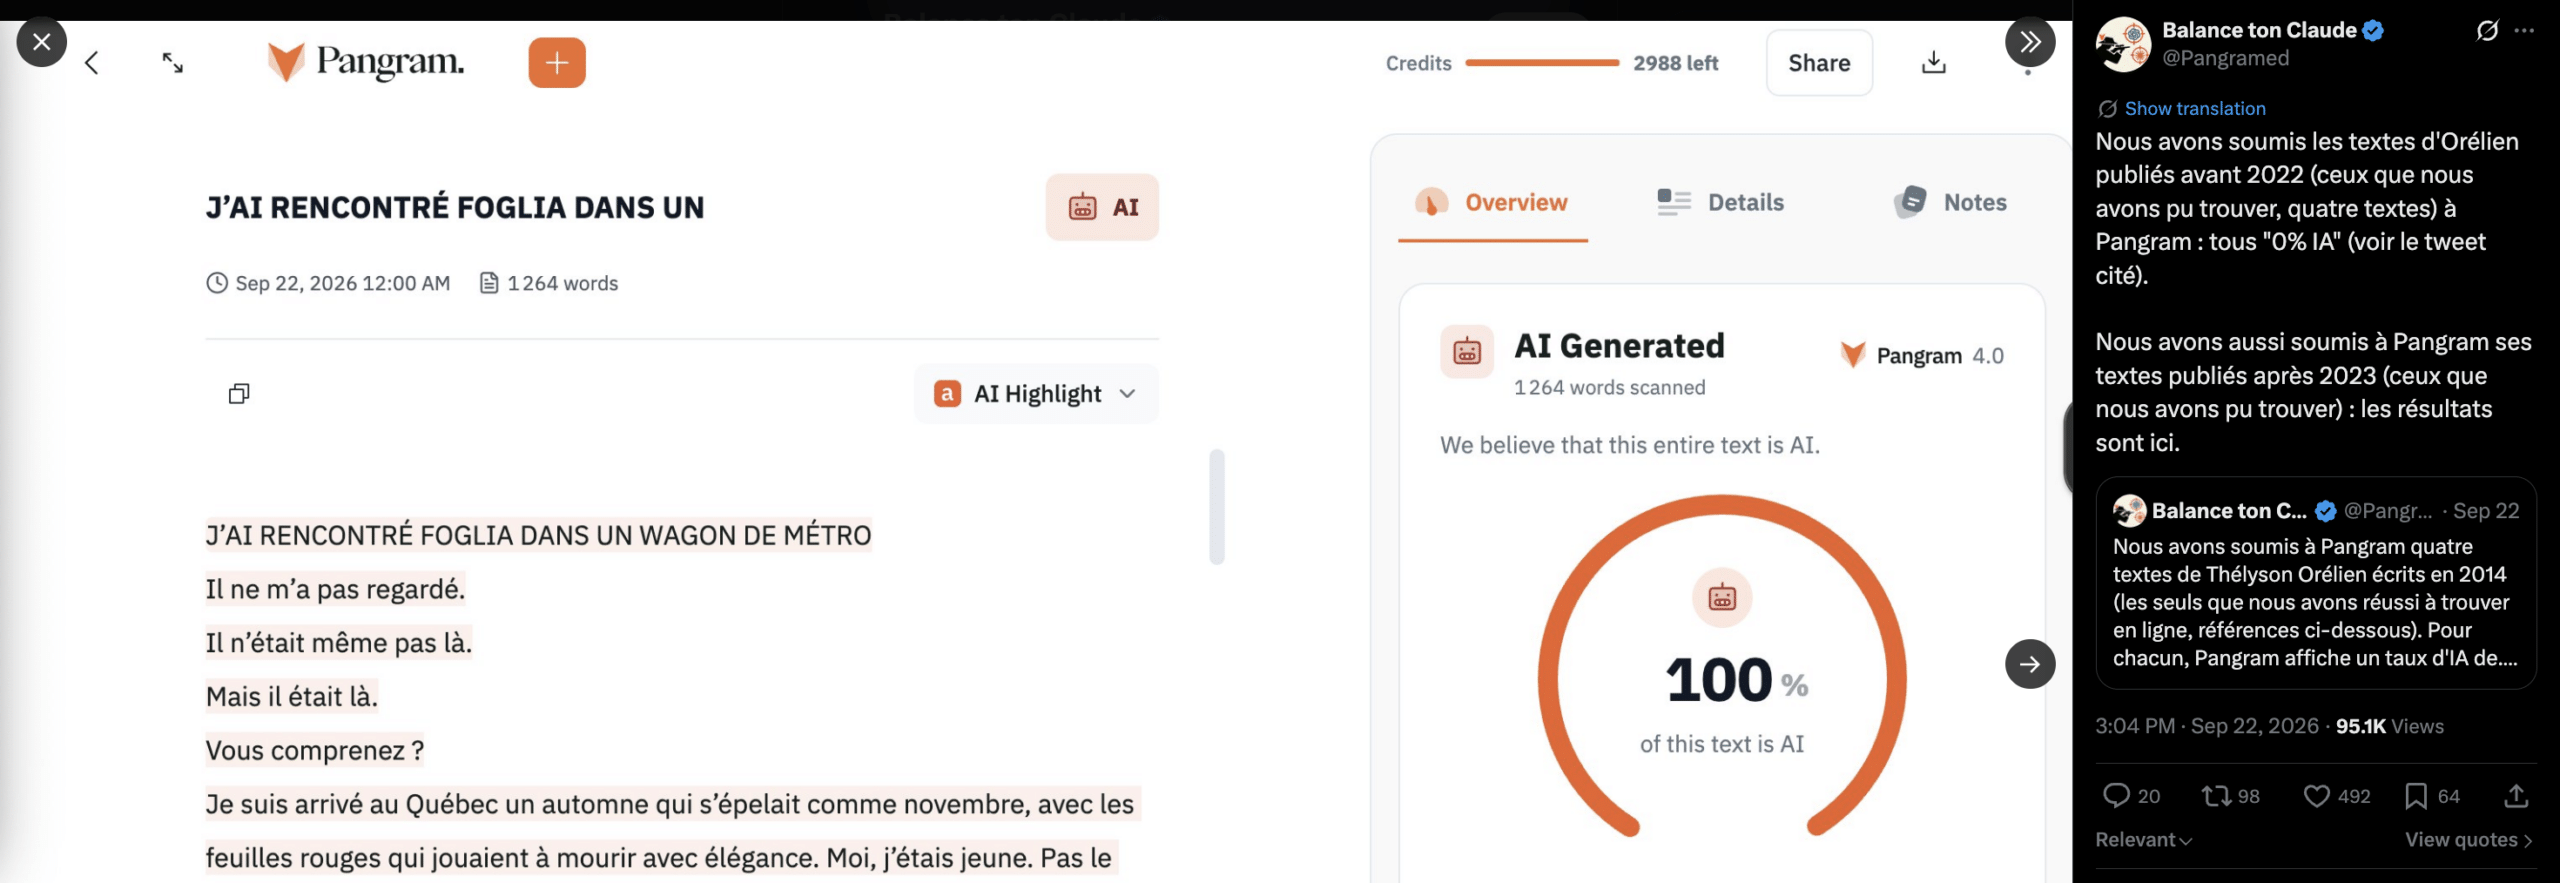
Le 21 septembre 2026, un compte anonyme sur X a affirmé, captures d’écran du détecteur Pangram à l’appui, que le roman phare de la rentrée littéraire avait été écrit « presque intégralement » par une intelligence artificielle. L’occasion de (re)préciser ce qu’un score « 100% IA » établit (ou pas), et ce que cela change pour une organisation qui recevrait un jour la même capture d’écran.
Sommaire
1. Que reproche-t-on au roman de Thélyson Orélien ?
Le compte « Balance ton Claude », 92 abonnés au moment des faits, a publié ses accusations le 21 septembre 2026, le soir même où C’était ça ou mourir recevait le prix du roman Fnac. Le livre figure aussi dans les sélections du Goncourt, du Médicis et du Femina.
Le Monde a ensuite passé plus de la moitié du texte dans Pangram : plus de 95% d’IA, avec un « niveau de confiance élevé ». France Inter obtient entre 95% et 100% sur des extraits. Dans le même temps, franceinfo a soumis d’autres romans de la rentrée au même outil : Philippe Jaenada sort à 99% humain, Ananda Devi, Amélie Nothomb et Lucie Rico à 100%.
L’auteur dément et dit constituer un dossier avec ses éditeurs pour prouver qu’il a écrit son livre. Grasset dénonce une campagne de haine. Boréal, qui a publié le roman au Québec en mars 2026, dit ne pas prendre les allégations à la légère, tout en affirmant sa confiance dans le travail de l’écrivain.
Je n’ai aucun verdict à rendre sur ce livre. Ce qui m’intéresse ici, c’est l’objet qui a déclenché l’affaire : un score.
2. Comment fonctionne un détecteur d’IA ?
Pour faire simple, un modèle de langage (LLM) est une autocomplétion géante. À chaque mot, il choisit parmi les suites les plus probables. Le texte qu’il produit est donc, statistiquement, un texte sans surprise. Tous les détecteurs cherchent cette signature, de trois manières différentes.
-
- La mesure statistique. On fait relire le texte par un modèle de langage et on mesure à quel point chaque mot était prévisible, ce que les chercheur.euses appellent la perplexité. Un texte régulier, sans aspérités, devient suspect. Même quand un humain l’a écrit simplement.
-
- Le classifieur entraîné. C’est la méthode de Pangram. Selon sa documentation, l’entreprise fabrique pour chaque texte humain de son corpus un double généré par IA, puis entraîne un modèle à distinguer les deux. L’outil découpe ensuite le texte analysé en segments et rend, pour chacun, une catégorie (écrit par un humain, légèrement assisté, modérément assisté, entièrement généré), un score entre 0 et 1 et un niveau de confiance.
-
- Le filigrane. Le fournisseur de l’IA laisse, au moment de l’écriture, un motif invisible dans le choix des mots, que seul le détenteur d’une clé sait vérifier. C’est la seule méthode qui s’approche d’une preuve. Elle ne concerne que les textes produits par ce fournisseur, et seulement depuis qu’il l’a activée.
Denis Teyssou, responsable du Medialab de l’AFP, le résume dans la dépêche consacrée à l’affaire : un texte n’est qu’une distribution de mots et de ponctuation, sans signal physique à analyser, contrairement à une image. Le résultat d’un détecteur reste donc une probabilité, jamais un constat.
3. Que disent les études sur la fiabilité de Pangram ?
Elles lui sont favorables.
L’étude la plus citée, publiée en août 2025 par Brian Jabarian et Alex Imas, de la Booth School of Business de l’université de Chicago, compare trois détecteurs commerciaux (Pangram, Originality.ai et GPTZero) et un modèle open source. Pangram est le seul à tenir un plafond de 0,5% de faux positifs, c’est-à-dire de textes humains classés à tort comme générés, sans perdre sa capacité à repérer les textes produits par IA. Les outils open source testés, eux, classent jusqu’à 78% de textes humains comme générés.
Une seconde étude, menée à l’université du Maryland, lui attribue environ 2% d’erreurs sur des textes humains, selon la lecture qu’en fait Le Monde. Pangram annonce de son côté un taux de faux positifs de 0,003% sur les livres, d’après les chiffres relayés par Radio-Canada.
Le patron de Pangram, Max Spero, bornait lui-même l’usage de son outil en mai, auprès de The Atlantic : il ne devrait jamais être l’arbitre final, mais le point de départ d’une enquête.
4. Comment ces chiffres ont-ils été mesurés ?
Trois éléments de méthode pèsent sur ce qu’on en tire.
-
- La langue. Le corpus de Chicago compte 1.992 textes humains antérieurs à 2020 et autant de textes générés, répartis en six genres : actualité, blogs, avis de consommateurs, romans, avis de restaurants et CV. Tous en anglais. Aucune donnée de cette étude ne porte sur le français.
-
- La pureté des textes. Les textes testés sont entièrement humains, ou entièrement générés par quatre modèles (GPT-4.1, Claude Opus 4, Claude Sonnet 4 et Gemini 2.0 Flash). La vraie vie se joue entre les deux : la correction, la traduction, la réécriture, la relecture éditoriale.
-
- La vitesse des versions. Pangram 4, sorti le 29 juillet 2026, prend officiellement en charge le français. Je n’ai trouvé aucune évaluation indépendante de cette version. Et Pangram prévient lui-même, dans ses fiches techniques, qu’un benchmark externe cesse d’être une mesure fiable une fois publié, puisqu’un modèle s’entraîne facilement dessus.
Surtout, la catégorie « entièrement généré » ne dit pas qui a écrit. La documentation de Pangram précise qu’un texte ainsi classé sort en général directement d’un modèle comme ChatGPT, mais qu’il est parfois un texte humain à l’origine, réécrit ou assisté si fortement que l’IA en devient l’autrice principale.
Un score décrit donc l’état final d’un texte. Il ignore tout de son histoire : qui a rédigé le premier jet, qui l’a corrigé, avec quel outil, à quelle étape.
5. Pourquoi neuf détecteurs donnent-ils neuf résultats différents ?
L‘AFP a soumis les extraits choisis par le compte anonyme à huit autres outils. InVID-WeVerify, qu’elle a cocréé, les juge très probablement humains. Un autre conclut à 100% d’IA, deux concluent l’inverse, et les quatre derniers affichent des probabilités qui varient d’un extrait à l’autre.
Face à un texte contesté, chacun peut donc trouver l’outil qui lui donne raison. L’accusation choisit celui qui confirme, la défense a tout loisir de faire l’inverse, et aucun des deux camps n’a rien prouvé.
6. Les détecteurs d’IA sont-ils biaisés contre certaines écritures ?
Ils l’ont été, de façon documentée. En 2023, une équipe de Stanford a testé sept détecteurs sur 91 dissertations rédigées par des étudiant.es non anglophones pour l’examen TOEFL. Plus de la moitié ont été classées comme générées par IA, avec un taux moyen de faux positifs de 61,3%, alors que les dissertations d’élèves américains passaient presque toutes. L’explication tient à la perplexité : un vocabulaire plus restreint rend une écriture plus prévisible.
Pangram affirme avoir réglé le problème et annonce 0% de faux positifs sur ce même jeu de 91 textes. En anglais, toujours. Pour le français d’un auteur nourri de traditions haïtiennes et caribéennes, qui revendique ses répétitions et ses rythmes, aucune mesure publique n’existe.
Ophélie Fraisier-Vannier, chercheuse à l’Institut de recherche en informatique de Toulouse, rappelait d’ailleurs au Monde que la précision de ces outils baisse hors de l’anglais et sur les formats inhabituels.
Pour être complet, Le Monde a testé cinq romans anciens au style radical, et Pangram les a tous classés humains. L’hypothèse du biais n’est donc pas démontrée dans ce cas. Mais elle n’est pas écartée non plus…
7. Qu’est-ce qui a trahi la rectrice de l’UGent ?
Aucun détecteur. En septembre 2025, Petra De Sutter prononce son discours de rentrée à l’université de Gand. En janvier 2026, le média flamand Apache révèle qu’il contient deux citations inventées, l’une attribuée à Albert Einstein, l’autre à l’auteur Paul Verhaeghe. Ce sont des collègues de l’université qui ont repéré les erreurs.
La porte-parole de l’UGent a confirmé qu’une IA générative avait déformé des citations et des références pendant la phase d’édition. L’université a corrigé la transcription publiée sur son site et y a ajouté une note de contexte. La rectrice a renoncé au doctorat honoris causa que devait lui remettre l’université d’Amsterdam. Et Apache a rappelé que la politique de l’UGent attend de chaque utilisateur de l’IA qu’il vérifie et corrige ce qu’elle produit.
Ce cas belge montre ce qui se vérifie. Le style d’un texte ne prouve rien. Une citation attribuée à quelqu’un qui ne l’a jamais écrite, si. Le risque que court une organisation avec l’IA porte d’abord sur l’attribution : qui a dit quoi, d’où vient ce chiffre, où se trouve cette source. Cette vérification-là ne demande aucun logiciel, et c’est la première règle que j’écrirais dans une charte IA.
8. Les universités belges se fient-elles aux détecteurs d’IA ?
L’UCLouvain a tranché dès juin 2024. Son groupe de travail sur l’IA générative écrit que les détecteurs ne permettent ni de déterminer avec précision si un texte a été généré, ni de donner un résultat définitif. Il avance trois raisons : le risque permanent d’accuser à tort, l’obsolescence rapide des outils face aux nouveaux modèles, et le fait qu’analyser le travail d’un·e étudiant·e revient souvent à le confier à une société externe, ce qui pose une question éthique et juridique.
Ce dernier point vaut pour n’importe quelle organisation. Passer la lettre de motivation d’une candidate ou la note d’un collaborateur dans un détecteur américain, c’est transférer un document personnel à un tiers. Et depuis l’arrêt SCHUFA de la Cour de justice de l’Union européenne, un score qui pèse de façon déterminante dans une décision devient lui-même une décision automatisée au sens de l’article 22 du RGPD.
9. Le filigrane imposé par l’AI Act va-t-il régler la question ?
Il aidera, sans régler les cas comme celui-ci. L’article 50 de l’AI Act s’applique depuis le 2 août 2026, et le marquage lisible par machine bénéficie d’un délai jusqu’au 2 décembre 2026 pour les systèmes déjà sur le marché. Les fournisseurs se sont engagés via le code de bonnes pratiques de la Commission européenne.
Anthropic marque désormais les textes générés par Claude d’un filigrane dérivé de la méthode SynthID de Google. L’entreprise précise que les détecteurs du marché, faute de clé, en restent aux tics d’écriture des modèles. Son propre outil de détection est en aperçu privé, réservé aux régulateurs, médias, vérificateurs de faits, chercheurs et organisations éligibles de l’Union.
Trois limites en découlent. Rien n’est rétroactif. Chaque fournisseur a sa propre clé, si bien que l’absence d’un filigrane ne prouve rien. Et l’obligation d’étiquetage des textes vise ceux qui informent le public sur des questions d’intérêt général, pas une œuvre de fiction.
10. Que change un score « 100% IA » pour votre organisation ?
Tout ce qu’une organisation publie passe désormais, potentiellement, dans un détecteur tenu par n’importe qui : un discours de CEO, un rapport annuel, un communiqué, une tribune, un post LinkedIn. Le jour où une capture d’écran circule, la question posée à la direction de la communication devient concrète. Qui est en mesure de montrer comment ce texte a été écrit ?
Dans la plupart des organisations que je vois, personne. Pas faute de rigueur. Parce que personne n’a écrit qui rédige, qui relit, avec quels outils, ni où se gardent les versions.
C’est pourtant la seule défense qui tienne face à un score. Thélyson Orélien travaille son texte depuis 2017, selon Grasset. S’il existe des versions datées de ces passages antérieures à l’arrivée de ChatGPT, en novembre 2022, elles pèseront plus lourd que n’importe quel détecteur.
Une organisation qui garde ses brouillons, ses validations et la trace des outils employés répond en une heure. Celle qui ne les garde pas n’a que sa parole à opposer à une capture d’écran.
Si demain une capture « 100% IA » visait le discours de votre CEO, combien d’heures vous faudrait-il pour montrer comment il a été écrit ?
