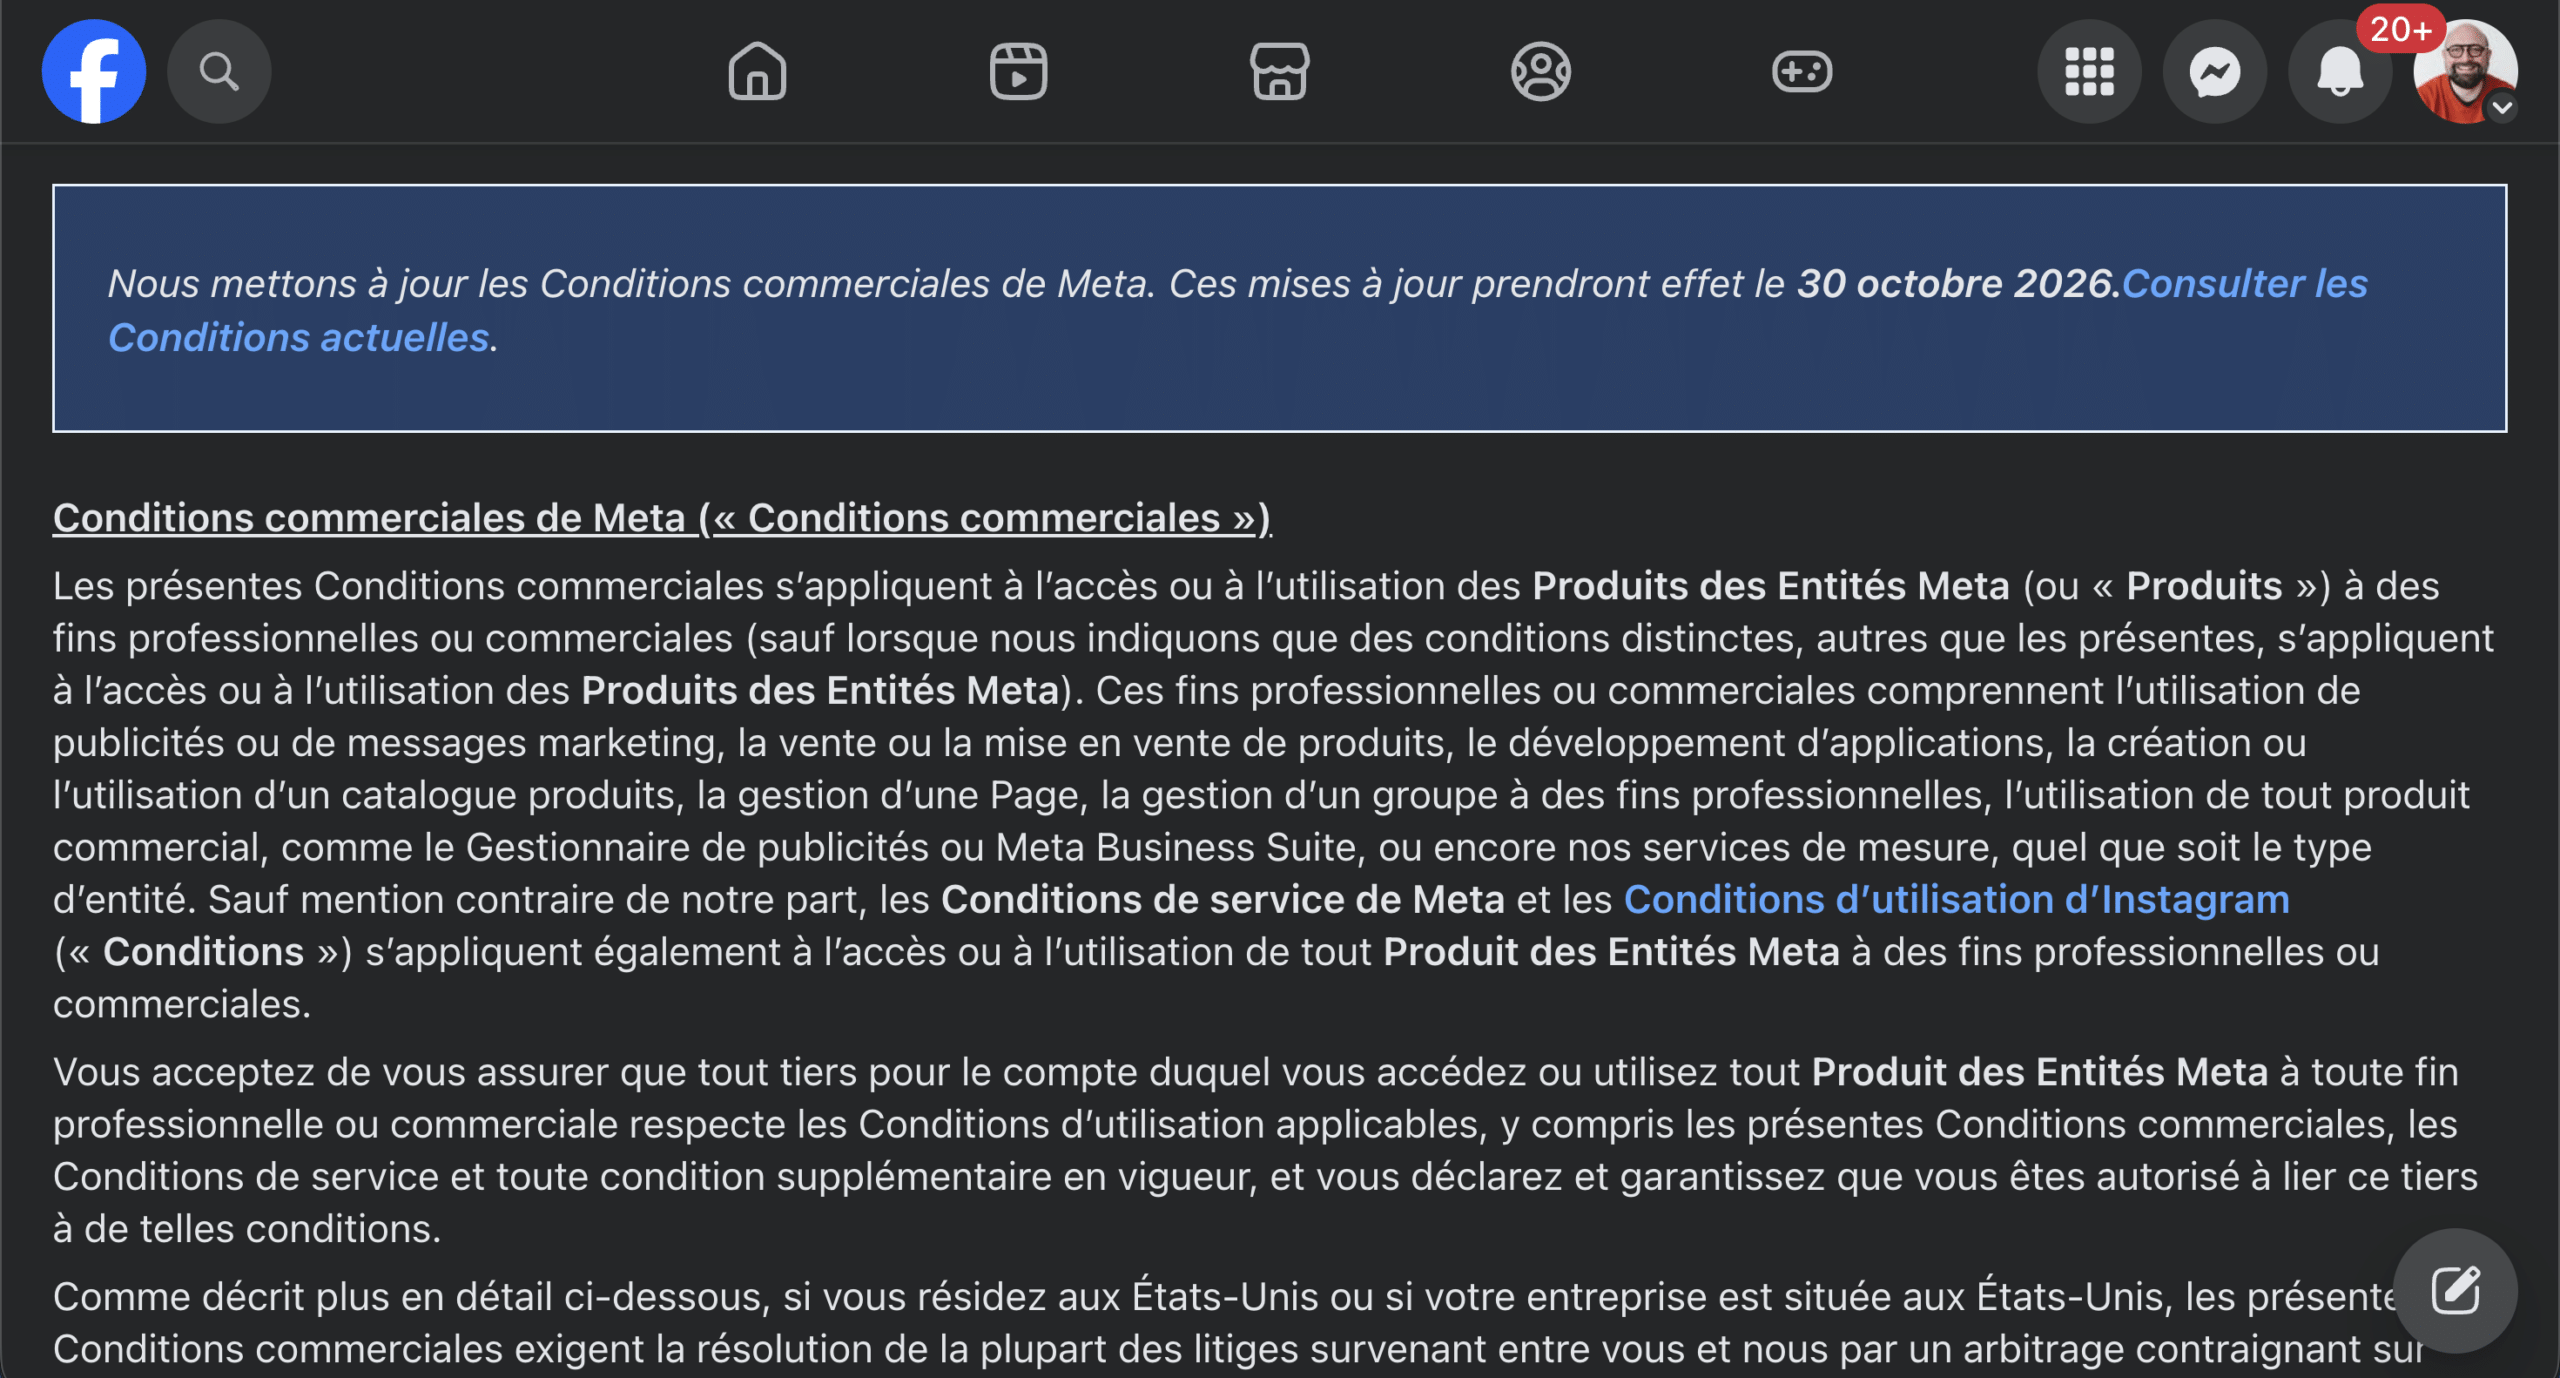
Meta a revu ses conditions commerciales. À partir du 20 novembre 2026, tout compte professionnel l’autorise à explorer et à collecter le contenu du site qui lui est associé. La presse a obtenu le retrait d’un mot et un report de 3 semaines. Voici le texte, la séquence qui l’a fait bouger, ce qu’il engage pour une entreprise ou une institution belge, et sa différence avec ce que Google fait déjà.
Par Xavier Degraux, consultant et formateur en prise de parole et en réputation des organisations, ancien journaliste économique (L’Echo, Trends), maître de conférences à l’Université de Liège.
J’ai co-rédigé cet article avec l’IA
Ce qu’il faut retenir
► À partir du 20 novembre 2026 (date reportée du 30 octobre, toujours citée dans le texte en français de Meta), les conditions commerciales de Meta autorisent ses robots à explorer, mettre en cache et collecter le contenu des sites « associés » aux comptes professionnels.
► Le 16 octobre, sous la pression des éditeurs, Meta a retiré le mot « train » (entraîner) et limité l’usage du contenu collecté à ses produits publicitaires et professionnels. Le droit d’explorer n’a pas bougé.
► La clause vaut pour tous les comptes professionnels, médias ou non. Refuser les conditions revient à renoncer aux outils professionnels de Meta.
► Le contrat ne mentionne pas robots.txt, le fichier qui indique aux robots les pages d’un site qu’ils peuvent lire. Meta affirme le respecter.
► Google explore aussi votre site, depuis toujours, sans vous faire signer quoi que ce soit. Depuis le 31 août 2026, un réglage de la Search Console permet toutefois de sortir de ses aperçus IA.
Le 20 novembre 2026, toute organisation qui gère une page Facebook, un compte Instagram professionnel, un compte Threads ou un canal WhatsApp aura donné à Meta le droit d’explorer son site web. Elle n’aura rien signé de sa main. Il lui suffira de continuer à se servir des outils professionnels du groupe.
La clause figure dans les nouvelles conditions commerciales de Meta, le contrat qui encadre l’usage professionnel de ses plateformes. Nieman Lab, le laboratoire de journalisme de la fondation Nieman à Harvard, l’a révélée le 15 octobre 2026. La presse a réagi la première. Mais elle est loin d’être la seule visée.
Que s’autorise Meta à partir du 20 novembre ?
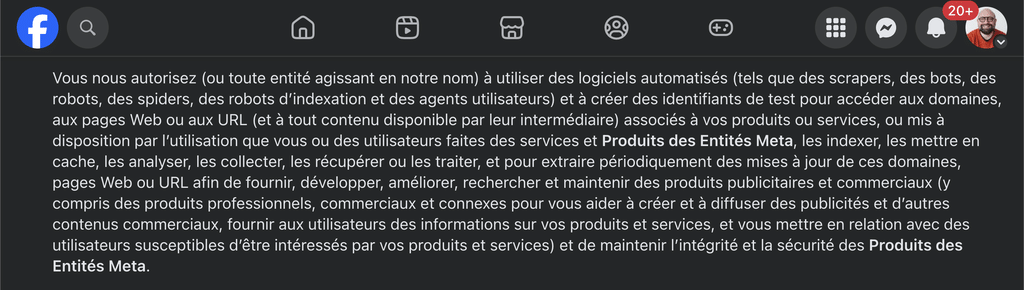
J’ai lu le texte révisé de la clause, publié le 16 octobre dans la version à venir des conditions commerciales de Meta et cité en entier par Nieman Lab le lendemain. Il se lit en 2 temps.
D’abord, l’entreprise autorise Meta, « ou toute entité agissant pour son compte », à utiliser des logiciels automatisés (scrapers, bots, robots d’exploration) pour accéder aux domaines, pages et URL associés à ses produits ou services. Meta peut les indexer, les mettre en cache, les analyser, en collecter le contenu et y revenir périodiquement pour en tirer les mises à jour.
Ensuite, ces contenus servent à « fournir, développer, améliorer, rechercher et maintenir » les produits publicitaires et professionnels du groupe. Meta cite comme exemples ses publicités, les Meta Business Tools et Meta Business Suite, l’interface qui sert à gérer pages et comptes publicitaires.
La clause autorise aussi Meta à créer des identifiants de test (« test credentials »). Pour les juristes consultés par Nieman Lab, ces comptes lui permettraient de franchir une page de connexion. Et la notion de site « associé » n’est définie nulle part.
Le contrat ne prévoit pas de refus partiel. L’organisation qui n’accepte pas les conditions doit cesser d’utiliser les produits professionnels de Meta.
Jusqu’ici, une permission comparable existait, mais seulement pour les annonceurs qui se servaient des outils d’IA générative publicitaires de Meta. Le contenu collecté ne pouvait alors servir qu’à « optimiser vos publicités ». Nieman Lab parle d’une extension substantielle. Meta parle d’un regroupement de textes existants, destiné à les rendre plus lisibles.
Comment la presse a fait reculer Meta… d’un mot
La séquence a duré 8 jours.
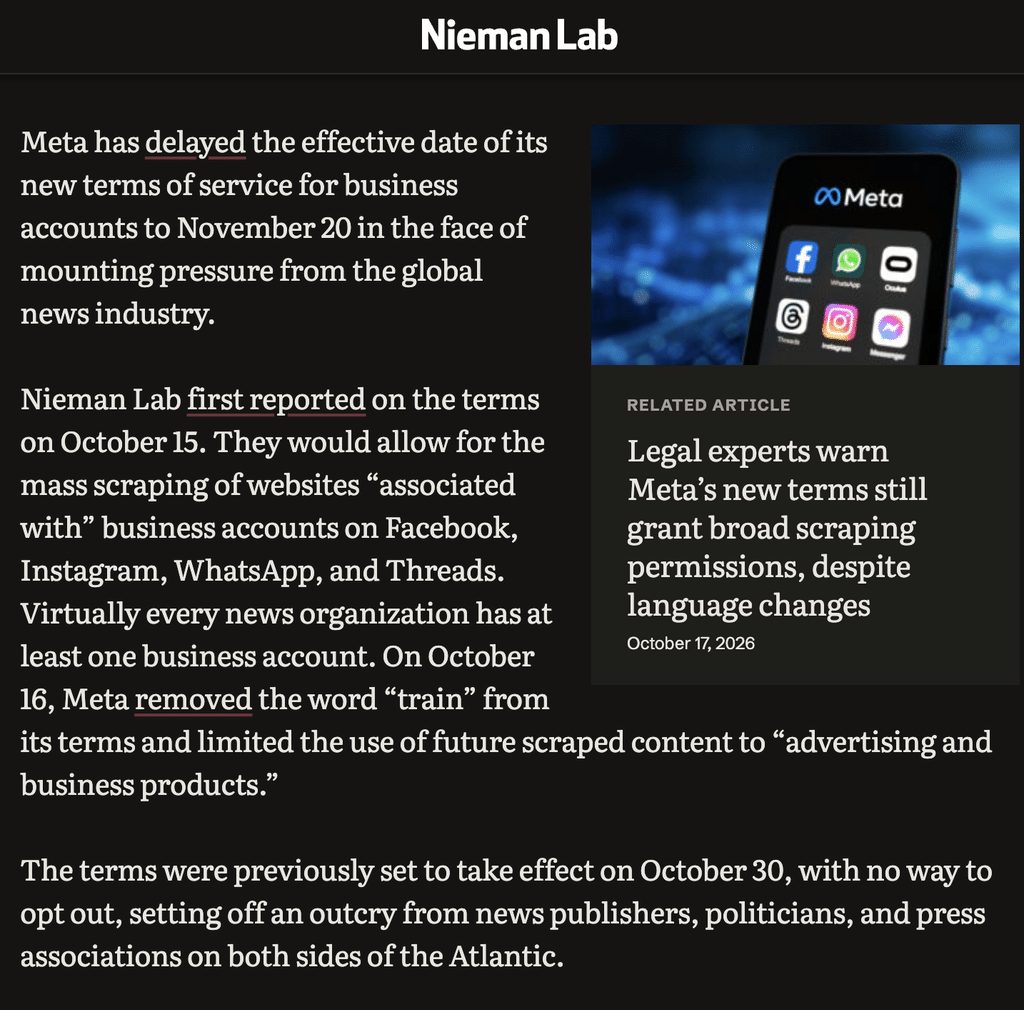
► 15 octobre. Nieman Lab publie la version d’origine. Meta pouvait utiliser « tout contenu » de ces sites pour « provide, develop, improve, research, train » ses produits. Des juristes y lisent une autorisation d’entraîner ses modèles d’IA sur les contenus des éditeurs, sans licence.
► 16 octobre. L’European Publishers Council (EPC) annonce qu’il saisira la Commission européenne. Au Royaume-Uni, la News Media Association demande l’intervention du gouvernement. L’après-midi même, Meta retire le mot « train » et limite l’usage du contenu à ses produits publicitaires et professionnels.
► 17 octobre. Un porte-parole de Meta explique la révision : la première version ne disait pas clairement que les préférences inscrites dans robots.txt sont respectées.
► 23 octobre. Meta repousse l’entrée en vigueur au 20 novembre, pour se donner « plus de temps » et expliquer les changements (déclaration reprise par Reuters et par Nieman Lab). WAN-IFRA, l’association mondiale des éditeurs de presse, écrit à Meta. L’EPC envoie une deuxième lettre à la Commission, au titre du droit de la concurrence et du Digital Markets Act (DMA), le règlement européen qui encadre les très grandes plateformes.
Aux États-Unis, la News/Media Alliance, première organisation d’éditeurs du pays, juge les conditions « outrageantes et probablement illégales ».
Bilan : un mot et 3 semaines. Au 23 octobre, selon Nieman Lab, Meta n’avait rien changé d’autre que la date. L’autorisation d’explorer, les identifiants de test et le silence sur robots.txt figurent toujours dans le texte.
Les juristes consultés par Nieman Lab restent sceptiques. Pour Matt Topic (cabinet Loevy & Loevy), « développer » est assez large pour inclure « entraîner », d’autant que les « produits professionnels » ne sont pas définis. James Grimmelmann (Cornell) trouve la formule assez large « pour y faire passer un camion ». Benjamin Sobel (université du Wisconsin) compare robots.txt à une pancarte « ne regardez pas ma maison » : une préférence, sans droit opposable.
WAN-IFRA demande de suspendre la clause pour les éditeurs de presse le temps d’un dialogue, de supprimer les identifiants de test et de renoncer à contourner les paywalls. Elle veut aussi un robots.txt rendu contraignant dans le contrat, l’exclusion de tout usage des contenus de presse pour l’IA sans licence, et le droit de refuser la clause sans perdre l’accès aux outils. Son directeur général, Stig Ørskov, salue le report… en ajoutant qu’il ne répond pas aux préoccupations des éditeurs.
Pourquoi une entreprise ou une institution est visée autant qu’un média
La clause ne cite aucun secteur. Elle s’applique à toute organisation qui utilise les produits de Meta à des fins professionnelles : une page Facebook, un compte Instagram professionnel, un compte publicitaire, Meta Business Suite.
L’EPC l’écrit lui-même dans sa lettre du 23 octobre : « these concerns extend across sectors ». Sa directrice générale, Angela Mills Wade, ajoute qu’aucune entreprise ne devrait avoir à céder des droits étrangers au service qu’elle a demandé.
Quitter Facebook ne se discute pas sérieusement dans la plupart des organisations belges. 71% des adultes belges s’y rendent chaque semaine, selon le Digital News Report 2026 du Reuters Institute (enquête YouGov auprès de 2.039 personnes). Le « contrat » s’appuie sur cette dépendance. Benjamin Sobel la rapproche d’une vente liée, une pratique que le droit de la concurrence peut sanctionner.
J’y vois 3 conséquences pour une direction de la communication.
1. La décision se prend là où se trouvent les accès. Le 20 novembre, la personne qui administre Meta Business Suite, souvent un community manager, parfois une agence, « accepte » au nom de l’organisation. Une licence d’exploration du site est alors accordée sans que la direction juridique ni la direction de la communication en aient décidé.
2. Le périmètre dépasse le site vitrine. « Associé » n’est pas défini, et les identifiants de test pourraient, selon les juristes, ouvrir les pages protégées par une connexion : un espace client, une plateforme de candidature, un extranet de partenaires. Meta n’a pas dit ce qu’il en ferait. Le contrat ne l’en empêche pas.
3. Une exception pour la presse laisserait les autres seules. La première demande de WAN-IFRA porte sur les éditeurs de presse. Si Meta l’accorde, la banque, l’hôpital ou le SPF qui a une page Facebook restera couvert par la clause, sans fédération pour négocier à sa place.
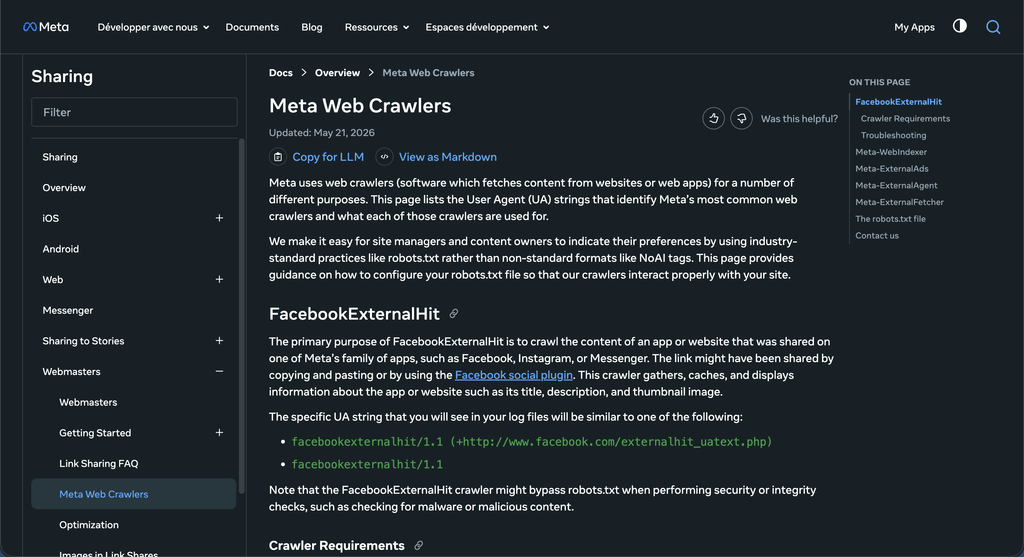
Meta documente publiquement 5 robots d’exploration. L’un d’eux, Meta-ExternalAds, explore le web, selon Meta, pour la publicité et d’autres produits ou services liés aux entreprises, l’usage même de la clause révisée. Meta indique qu’il se bloque dans robots.txt. 2 autres peuvent passer outre ce fichier : celui qui fabrique l’aperçu d’un lien partagé (pour des contrôles de sécurité) et celui qui va chercher une page à la demande d’un utilisateur (page des robots de Meta, consultée le 24 octobre 2026).
Une organisation dispose donc d’un moyen technique de dire non. Mais le contrat ne lui garantit pas que ce non sera respecté…
Google lit déjà votre site, sans rien vous faire signer
Googlebot, le robot de Google, explore le web depuis la fin des années 1990 sans demander de signature. Un site le laisse passer parce qu’il veut être trouvé. Les quotidiens francophones belges vont jusqu’à lui ouvrir leurs articles payants, condition pour rester indexés, alors qu’ils bloquent les robots de ChatGPT et de Perplexity (lire cet article de la RTBF, Décrypte, pour lequel j’ai été interviewé).
L’usage du contenu a changé avec les aperçus IA, ces résumés générés que Google affiche au-dessus de ses résultats. Le jeton Google-Extended permet de refuser que ses pages servent à entraîner Gemini. Google précise qu’il n’a aucun effet sur l’inclusion dans la recherche, dont les aperçus font partie. Jusqu’à l’été 2026, sortir des aperçus obligeait à supprimer ou à raccourcir ses extraits (le texte affiché sous chaque lien) dans toute la recherche.
Il a fallu un régulateur pour que cela change. Le 3 juin 2026, la CMA, l’autorité britannique de la concurrence, a imposé à Google de laisser les éditeurs retirer leurs contenus de ses fonctions IA sans quitter la recherche classique.
Depuis le 31 août 2026, un réglage de la Search Console permet à tout site, dans le monde, de s’exclure des aperçus IA, de l’AI Mode et des fonctions IA de Discover (« opt-out »). L’inclusion reste le réglage par défaut. De son côté, la Commission européenne enquête depuis décembre 2025 sur l’usage que Google fait des contenus des éditeurs dans ces fonctions.
Ce réglage, je l’ai décrit à la RTBF comme un faux choix. L’organisation qui s’exclut laisse sa place à celles qui restent, et le résumé s’affiche quand même.
| Meta | ||
|---|---|---|
| Fondement de l’accès | L’usage : le robot passe, le site le laisse passer pour rester visible | Le contrat : le compte professionnel l’autorise par écrit |
| Contenu exploré | Le web public | Les sites « associés » aux comptes, y compris, selon des juristes, derrière une connexion grâce aux identifiants de test |
| Réglage par défaut | Inclusion dans les aperçus IA | Acceptation au 20 novembre 2026 |
| Moyens de refus | Réglage Search Console (depuis le 31 août 2026), robots.txt, Google-Extended pour Gemini | robots.txt selon Meta, sans engagement contractuel, ou renoncer aux outils professionnels |
| Régulateurs saisis | CMA (décision du 3 juin 2026), Commission européenne (enquête ouverte en décembre 2025) | Commission européenne et CMA (demandes d’octobre 2026) |
Des 2 côtés, le mécanisme se ressemble : l’accès à votre audience contre l’accès à vos contenus. Chez Google, l’organisation subit un usage. Chez Meta, elle le signe.
Les questions encore ouvertes au 24 octobre
Le texte définitif peut encore changer d’ici le 20 novembre. La Commission européenne et la CMA n’ont pas répondu publiquement aux demandes de mesures provisoires.
Surtout, aucune décision de justice ne dit aujourd’hui si ce contrat primerait sur un robots.txt qui refuse les robots de Meta. Les déclarations de Meta décrivent ses intentions. Le contrat fixe ses droits.
Par où je commencerais
Comme une signature engage davantage qu’une absence de refus, et qu’elle se donne aujourd’hui au niveau de la personne qui détient les accès, je conseille aux dircoms de commencer par ceci :
1. Si ce n’est pas encore fait, je dresserais la liste des comptes professionnels Meta de l’organisation (pages, comptes publicitaires, Business Suite) et, en face, le nom de la personne qui les administre, agence comprise.
2. Je demanderais à la direction juridique de lire la clause avant le 20 novembre, et d’écrire qui, chez vous, a le mandat de l’accepter.
3. Je ferais trancher au même endroit, par les mêmes personnes, le sort des robots de Meta dans robots.txt et celui du réglage d’exclusion des aperçus IA de Google.
Questions fréquentes
Les nouvelles conditions commerciales de Meta concernent-elles toutes les entreprises ?
Oui. Elles s’appliquent à toute organisation qui utilise les produits de Meta à des fins professionnelles, qu’il s’agisse d’une page Facebook, d’un compte Instagram professionnel, d’un compte publicitaire ou de Meta Business Suite. La clause d’exploration ne distingue pas les médias des autres secteurs.
Quand entrent-elles en vigueur ?
Le 20 novembre 2026. Meta avait d’abord prévu le 30 octobre, puis a annoncé un report le 23 octobre 2026 après les protestations des éditeurs.
Meta peut-il entraîner son IA avec le contenu de mon site ?
Le mot « train » a été retiré le 16 octobre 2026. Le texte autorise encore Meta à développer ses produits publicitaires et professionnels avec le contenu collecté, et des juristes consultés par Nieman Lab estiment que cela peut couvrir l’entraînement. Meta répond que ces règles ne visent pas les sites d’information et ne lui donnent pas de nouveaux droits qui primeraient sur les préférences inscrites dans robots.txt.
Un fichier robots.txt suffit-il pour bloquer Meta ?
Meta affirme le respecter et documente un robot dédié à la publicité, Meta-ExternalAds, qui se bloque dans robots.txt. Le contrat, lui, ne mentionne pas ce fichier, et des juristes rappellent qu’il exprime une préférence sans créer de droit opposable.
En quoi est-ce différent de Google ?
Google explore le web sans contrat avec les sites, qui le laissent passer pour rester visibles. Depuis le 31 août 2026, un réglage de la Search Console permet de sortir de ses aperçus IA. Meta, lui, obtient une autorisation écrite par ses conditions commerciales, et le seul refus prévu consiste à renoncer à ses outils professionnels.
Pour aller plus loin
L’enquête d’origine de Nieman Lab (15 octobre 2026) cite la clause en entier, et le texte complet des nouvelles conditions se lit dans leur version à venir, sur le site de Meta. La lettre de WAN-IFRA et l’addendum sur le report sont résumés par InPublishing (23 octobre 2026). Meta décrit ses robots sur sa page dédiée aux webmasters, Google décrit Google-Extended dans sa documentation Search Central. Sur un autre outil dont l’usage se décide là où se trouvent les accès, j’ai décrit les risques des extensions LinkedIn pour une organisation. Et sur le lien entre Search Console, référencement et réseaux sociaux, mon article sur le GEO et la Search Console.
Ce que décrit cet article, je le documente pour une organisation dans le diagnostic de réputation et de prise de parole, qui ouvre mon offre de consultance.
Xavier Degraux ► Consultant & formateur LinkedIn™, IA et GEO · Prise de parole et réputation des organisations et de leurs dirigeant.es · Employee advocacy ► +500 organisations accompagnées depuis 2013 ► 10 ans journaliste éco (L’Echo, Trends)
