L’algospeak, ce langage qui déforme les mots pour échapper à la modération automatique des réseaux sociaux, n’est plus réservé aux ados. Cinq tendances documentées en dessinent l’évolution, des modèles de langage qui le décodent aux interdictions qui démultiplient les variantes. Reste, pour toute organisation qui parle de sujets sensibles, la question de savoir qui décide des mots qu’elle s’autorise.
J’ai optimisé cet article avec l’IA
Le 13 janvier 2026, la RTBF a dû s’expliquer devant un internaute. Il lui reprochait de déformer des mots, à coups de chiffres, d’astérisques ou de symboles, dans ses vidéos d’actualité publiées sur Facebook et Instagram. Le 29 septembre, La DH consacrait un article au même phénomène chez les adolescent·es. Entre ces deux dates, l’algospeak a changé d’échelle.
Un langage codé que personne ne mesure en Belgique
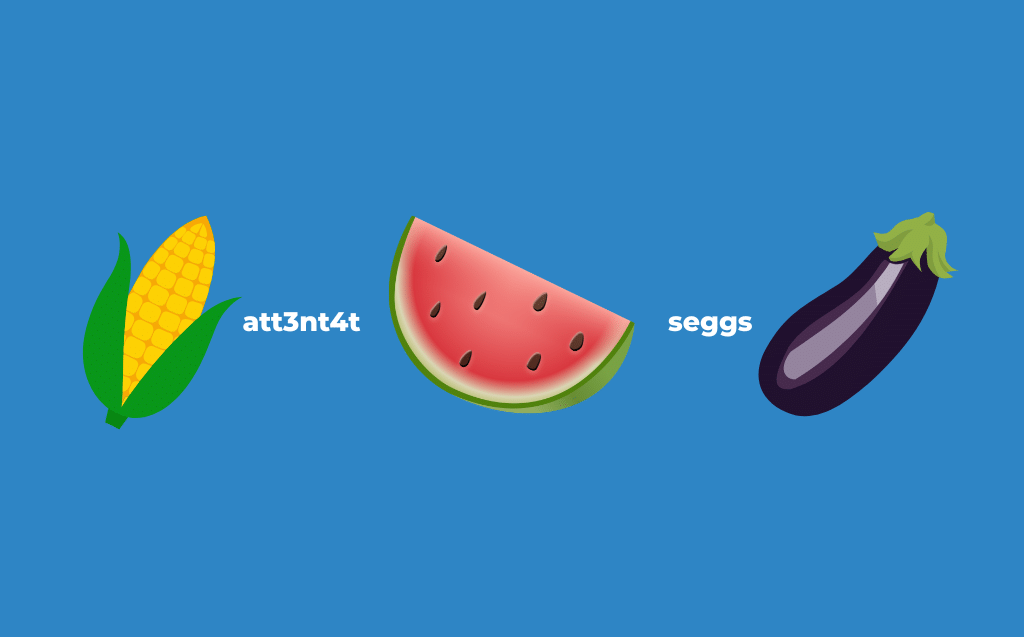
L’algospeak, contraction d’« algorithm » et de « speak », désigne les mots, emojis et détours employés pour qu’un système de modération automatique ne repère pas un sujet sensible. L’objectif est d’éviter la suppression, le déclassement ou la démonétisation, c’est-à-dire la perte des revenus publicitaires. « Unalive » pour mourir. « Seggs » pour sexe. Une pastèque pour la Palestine. Etc.
En français, le procédé le plus répandu remplace une lettre par un chiffre ou un symbole. Le Projet Voltaire relevait en janvier 2026 des graphies comme « vi0l », « att3nt4t » ou « gén0cide ». D’autres codes sont repris tels quels de l’anglais, comme « corn » pour pornographie.
Quelques-uns sont propres à notre langue : « le deuxième mot de comptine », une périphrase qui évite de nommer une drogue par exemple. Et les emojis complètent le tout : le flocon pour la cocaïne, l’aubergine pour le sexe masculin…
Les chiffres qui entourent ce phénomène sont maigres. Le plus repris vient d’un sondage Pollfish réalisé en août 2022 pour TELUS International auprès de 1.000 Américain·es : 51% disaient avoir déjà croisé de l’algospeak, 42% le voyaient progresser.
Je n’ai trouvé aucune mesure belge ni européenne. Les 5 tendances que je décris ici sont donc des mécanismes documentés, pas une ampleur mesurée chez nous.
Les modèles de langage lisent désormais entre les lignes
En juin 2024, Jan Fillies et Adrian Paschke ont soumis à GPT-4 des termes d’algospeak relevés dans la littérature scientifique. Le modèle en a rétabli le sens dans 79,4% des cas. Et avec une phrase d’exemple, 98,5%.
Or c’est vers ces modèles que basculent les plateformes. Le 25 juin 2026, le Financial Times rapportait que Meta confie déjà la moitié de la revue des contenus et des publicités à des modèles de langage. L’objectif dépasse 90% pour certains types de contenus, d’ici fin 2026 selon la plupart des reprises, d’ici 2027 selon MediaPost.
Autrement dit : avec l’IA, les codes meurent plus vite que jamais.
Le code quitte le texte
Du coup, quand l’écrit est lu et de plus en plus vite compris par la machine, le code migre ailleurs :
- Vers l’emoji (émoji carotte = vaccin par exemple).
- Vers la voix, jusqu’à ce que certains créateurs se disent persuadés que TikTok analyse aussi le son.
- Vers l’image, avec des références visuelles propres aux communautés pro-anorexie par exemple.
- Vers la tendance détournée, enfin, comme le #MascaraTrend, où « mascara » désignait un ou une partenaire, y compris pour évoquer des violences.
Pour une équipe de modération comme pour un parent, un emoji n’a donc pas de sens hors contexte. Et, en général, les lexiques qui circulent sont pertinents à peine quelques mois.
Des mots nés pour la machine arrivent dans la cour de récré
Pogressivement, certains codes sortent des réseaux sociaux, les créateurs et leurs followers les ayant en quelque sorte « démocratisé ». « Unalive », par exemple, est sorti de TikTok, pour rentrer dans le langage de plus en plus commun.
L’effet est double. Puisque, du coup, le mot banalisé ne protège plus rien.
Ainsi, selon BEE SECURE, le service luxembourgeois de sensibilisation au numérique, une recherche TikTok sur « sewer slide », déformation de « suicide », affiche les mêmes messages de prévention que le mot d’origine. Et un registre « enfantin » s’installe sur des sujets graves, sans que personne l’ait vraiment décidé.
Est-ce que ce registre atténue la perception du risque chez les jeunes qui l’emploient ? Aucune étude que j’ai trouvée ne le mesure, en tout cas.
Le soupçon politique revient, et les preuves se contredisent
Fin 2023, Human Rights Watch a documenté plus de 1.050 retraits ou restrictions de contenus sur Instagram et Facebook en deux mois, presque tous pacifiques et favorables à la Palestine. Dans la foulée, l’émoji pastèque (mêmes couleurs que le drapeau palestinien) s’est imposé…
Le 26 janvier 2026, quelques jours après le passage de TikTok US sous contrôle majoritairement américain, des utilisateurs et utilisatrices n’arrivaient plus à envoyer le mot « Epstein » en message privé. TikTok a répondu n’avoir aucune règle contre ce nom et a invoqué une panne de centre de données. Les tests de NPR montraient un blocage irrégulier. Le gouverneur de Californie a annoncé une enquête. Mais une série de nouveaux codes et périphrases ont commencé à pulluler…
Enfin, en juillet 2026, un audit portant sur 556.946 relevés de vues, 2.753 vidéos et 67 comptes TikTok consacrés à l’immigration, à Donald Trump et au conflit israélo-palestinien ne trouve pas trace d’une suppression modérée à forte selon la position politique. Ses auteurs écrivent eux-mêmes que cela ne prouve pas l’absence de toute distribution différenciée.
Je mets ces trois éléments côte à côte sans les départager. Ils ne portent ni sur les mêmes plateformes, ni sur les mêmes périodes, ni sur les mêmes méthodes. Leur point commun : sans accès aux règles de classement, personne ne tranche. Et tant que personne ne tranche, l’algospeak prospère.
Bannir un mot fabrique de l’audience
La tendance la plus ancienne est la moins connue. En 2016, une équipe de Georgia Tech a analysé 2,5 millions de publications Instagram parues entre 2011 et 2014 dans des communautés pro-troubles alimentaires. Après le blocage de plusieurs hashtags en 2012, les termes interdits se sont démultipliés en variantes, jusqu’à 107 pour « thighgap ».
> Les likes et commentaires sur les variantes étaient de 15 à 30% plus élevés que sur les termes d’origine.
> Ces variantes parlaient plus souvent d’automutilation, d’isolement et de pensées suicidaires.
> Une recherche qui ne renvoyait qu’au mot visé proposait désormais des dizaines de variantes non bloquées.
En janvier 2024, une recherche commandée par Ofcom, le régulateur britannique, a mesuré l’autre versant sur les moteurs de recherche : une requête volontairement cryptée expose six fois plus à du contenu nuisible lié à l’automutilation. Les chercheurs avaient désactivé les filtres de recherche sécurisée, et Google conteste la représentativité des termes testés.
Le vulgarisateur Adam Aleksic, auteur du livre « Algospeak » paru en 2025, parle d’un « Whac-A-Mole » linguistique, du nom du jeu de foire où la taupe qu’on frappe ressort par un autre trou. Petite nuance : ici, chaque coup de maillet creuse un nouveau trou.
Dès 2016, l’équipe de Georgia Tech recommandait de faire atterrir ces recherches sur des ressources d’aide plutôt que de bloquer les mots. C’est la politique que Meta décrit aujourd’hui pour Instagram.
Ce que le droit européen change, sur le papier
Que fait l’Europe ? Le DSA, le règlement européen sur les services numériques, ne dit pas un mot de l’algospeak. Mais il encadre ce qui le nourrit. Son article 17 oblige les plateformes à motiver toute restriction de visibilité d’un contenu, déclassement compris.
Le 5 juillet 2024, le tribunal d’Amsterdam l’a appliqué à X dans l’affaire Danny Mekić : masquer un compte des suggestions de recherche sans prévenir, le « shadowban », relève de cet article.
En Europe, le déclassement silencieux qui justifie l’algospeak n’a plus de base légale. S’il persiste, c’est l’indice d’une obligation mal appliquée.
L’article 28 impose aux plateformes accessibles aux mineur·es un niveau élevé de protection, précisé par des lignes directrices de la Commission du 14 juillet 2025, sans obligation générale de surveiller tous les contenus.
En Belgique, l’application du DSA passe par l’IBPT, coordinateur national des services numériques. Mais cette usine à gaz tourne presqu’à vide…
Toute la tension est là. Repérer un code demande de lire beaucoup, et de comprendre ce qu’on lit.
Ce que l’affaire RTBF dit aux organisations qui parlent de sujets sensibles
Revenons à la RTBF. Dans sa réponse du 13 janvier, elle explique que l’intention de départ était d’harmoniser la forme des contenus entre producteurs, et non de s’autocensurer. La pratique a débordé sur les légendes et les accroches, alors que Facebook et Instagram modèrent généralement moins strictement que TikTok.
Dans une vidéo sur l’actualité de Crans-Montana, le mot « décédé » avait été déformé. La RTBF a elle-même jugé la démarche excessive.
Elle pointe un autre effet, plus discret : les mots déformés deviennent introuvables dans les archives et dans les recherches. Sa charte d’utilisation des réseaux sociaux est en cours de révision. Pour faire simple, un média public a codé ses propres mots sans que personne l’ait décidé par écrit, et il a fallu la plainte d’un auditeur pour que la règle s’écrive.
Pour une mutualité, un centre de prévention, une administration de santé ou une association de jeunesse, la question est la même. Écrire « suicide », c’est risquer le déclassement. Coder, c’est risquer de ne plus être trouvé par les personnes qui cherchent de l’aide, et d’effacer ses propres archives. Si ce choix n’est écrit nulle part, il revient à la personne qui publie ce jour-là.
L’article 17 du DSA donne au moins un outil concret : quand une publication perd soudain sa portée, la plateforme doit un exposé des motifs.
Le vocabulaire codé changera encore plusieurs fois d’ici l’an prochain. La question qui restera, c’est de savoir qui, dans une organisation, décide des mots qu’elle s’autorise sur les sujets qui l’exposent.
Dans la vôtre, qui a tranché, et par écrit, la manière de nommer en ligne le suicide, la drogue ou la sexualité ?
Xavier Degraux ► Consultant & formateur LinkedIn™, IA et GEO · Prise de parole et réputation des organisations et de leurs dirigeant.es · Employee advocacy ► +500 organisations accompagnées depuis 2013 ► 10 ans journaliste éco (L’Echo, Trends)
À lire aussi : EU KIDS Act : décryptage en 17 questions du texte européen sur les mineurs et les réseaux sociaux et Détecteurs d’IA : que prouve un score « 100% IA » ?
